GenBox Free Tools (genbox.eu)
Nowa architektura ze Stanforda pisze tekst całymi warstwami
Trzeciego czerwca 2026 roku Matthew Prince, szef Cloudflare, napisał na X krótko: „Welp, that happened faster than I predicted”. Nie chodziło o nowy produkt ani przejęcie. Chodziło o to, że po raz pierwszy w historii sieci telemetria Cloudflare, obejmująca około jednej piątej całego ruchu w internecie, zanotowała więcej żądań od maszyn niż od ludzi. 57,5 procent ruchu pochodziło z botów, 42,5 procent od ludzi.
Trzy miesiące wcześniej, na konferencji South by Southwest, Prince prognozował, że boty wyprzedzą ludzi dopiero w 2027 roku. Jego logika była prosta: człowiek szukający aparatu odwiedza pięć stron, agent AI robi to samo, ale przegląda tysiąc stron w kilka sekund. Świat miał mieć jeszcze rok na przygotowanie. Nie miał.
Za tym wszystkim stoi jednak coś mniej widowiskowego niż „przebudzenie maszyn”: fizyczne ograniczenie, które do października 2026 roku wydawało się nieusuwalne. Modele językowe piszą jedno słowo naraz i to właśnie ten mechanizm stał się wąskim gardłem całej gospodarki treści. Zespół z laboratorium Hazy Research na Stanfordzie zaproponował architekturę, która omija to ograniczenie. Nazywa się Next Concept Modeling, w skrócie NCM.
Dlaczego model pisze wolno, choć liczy szybko
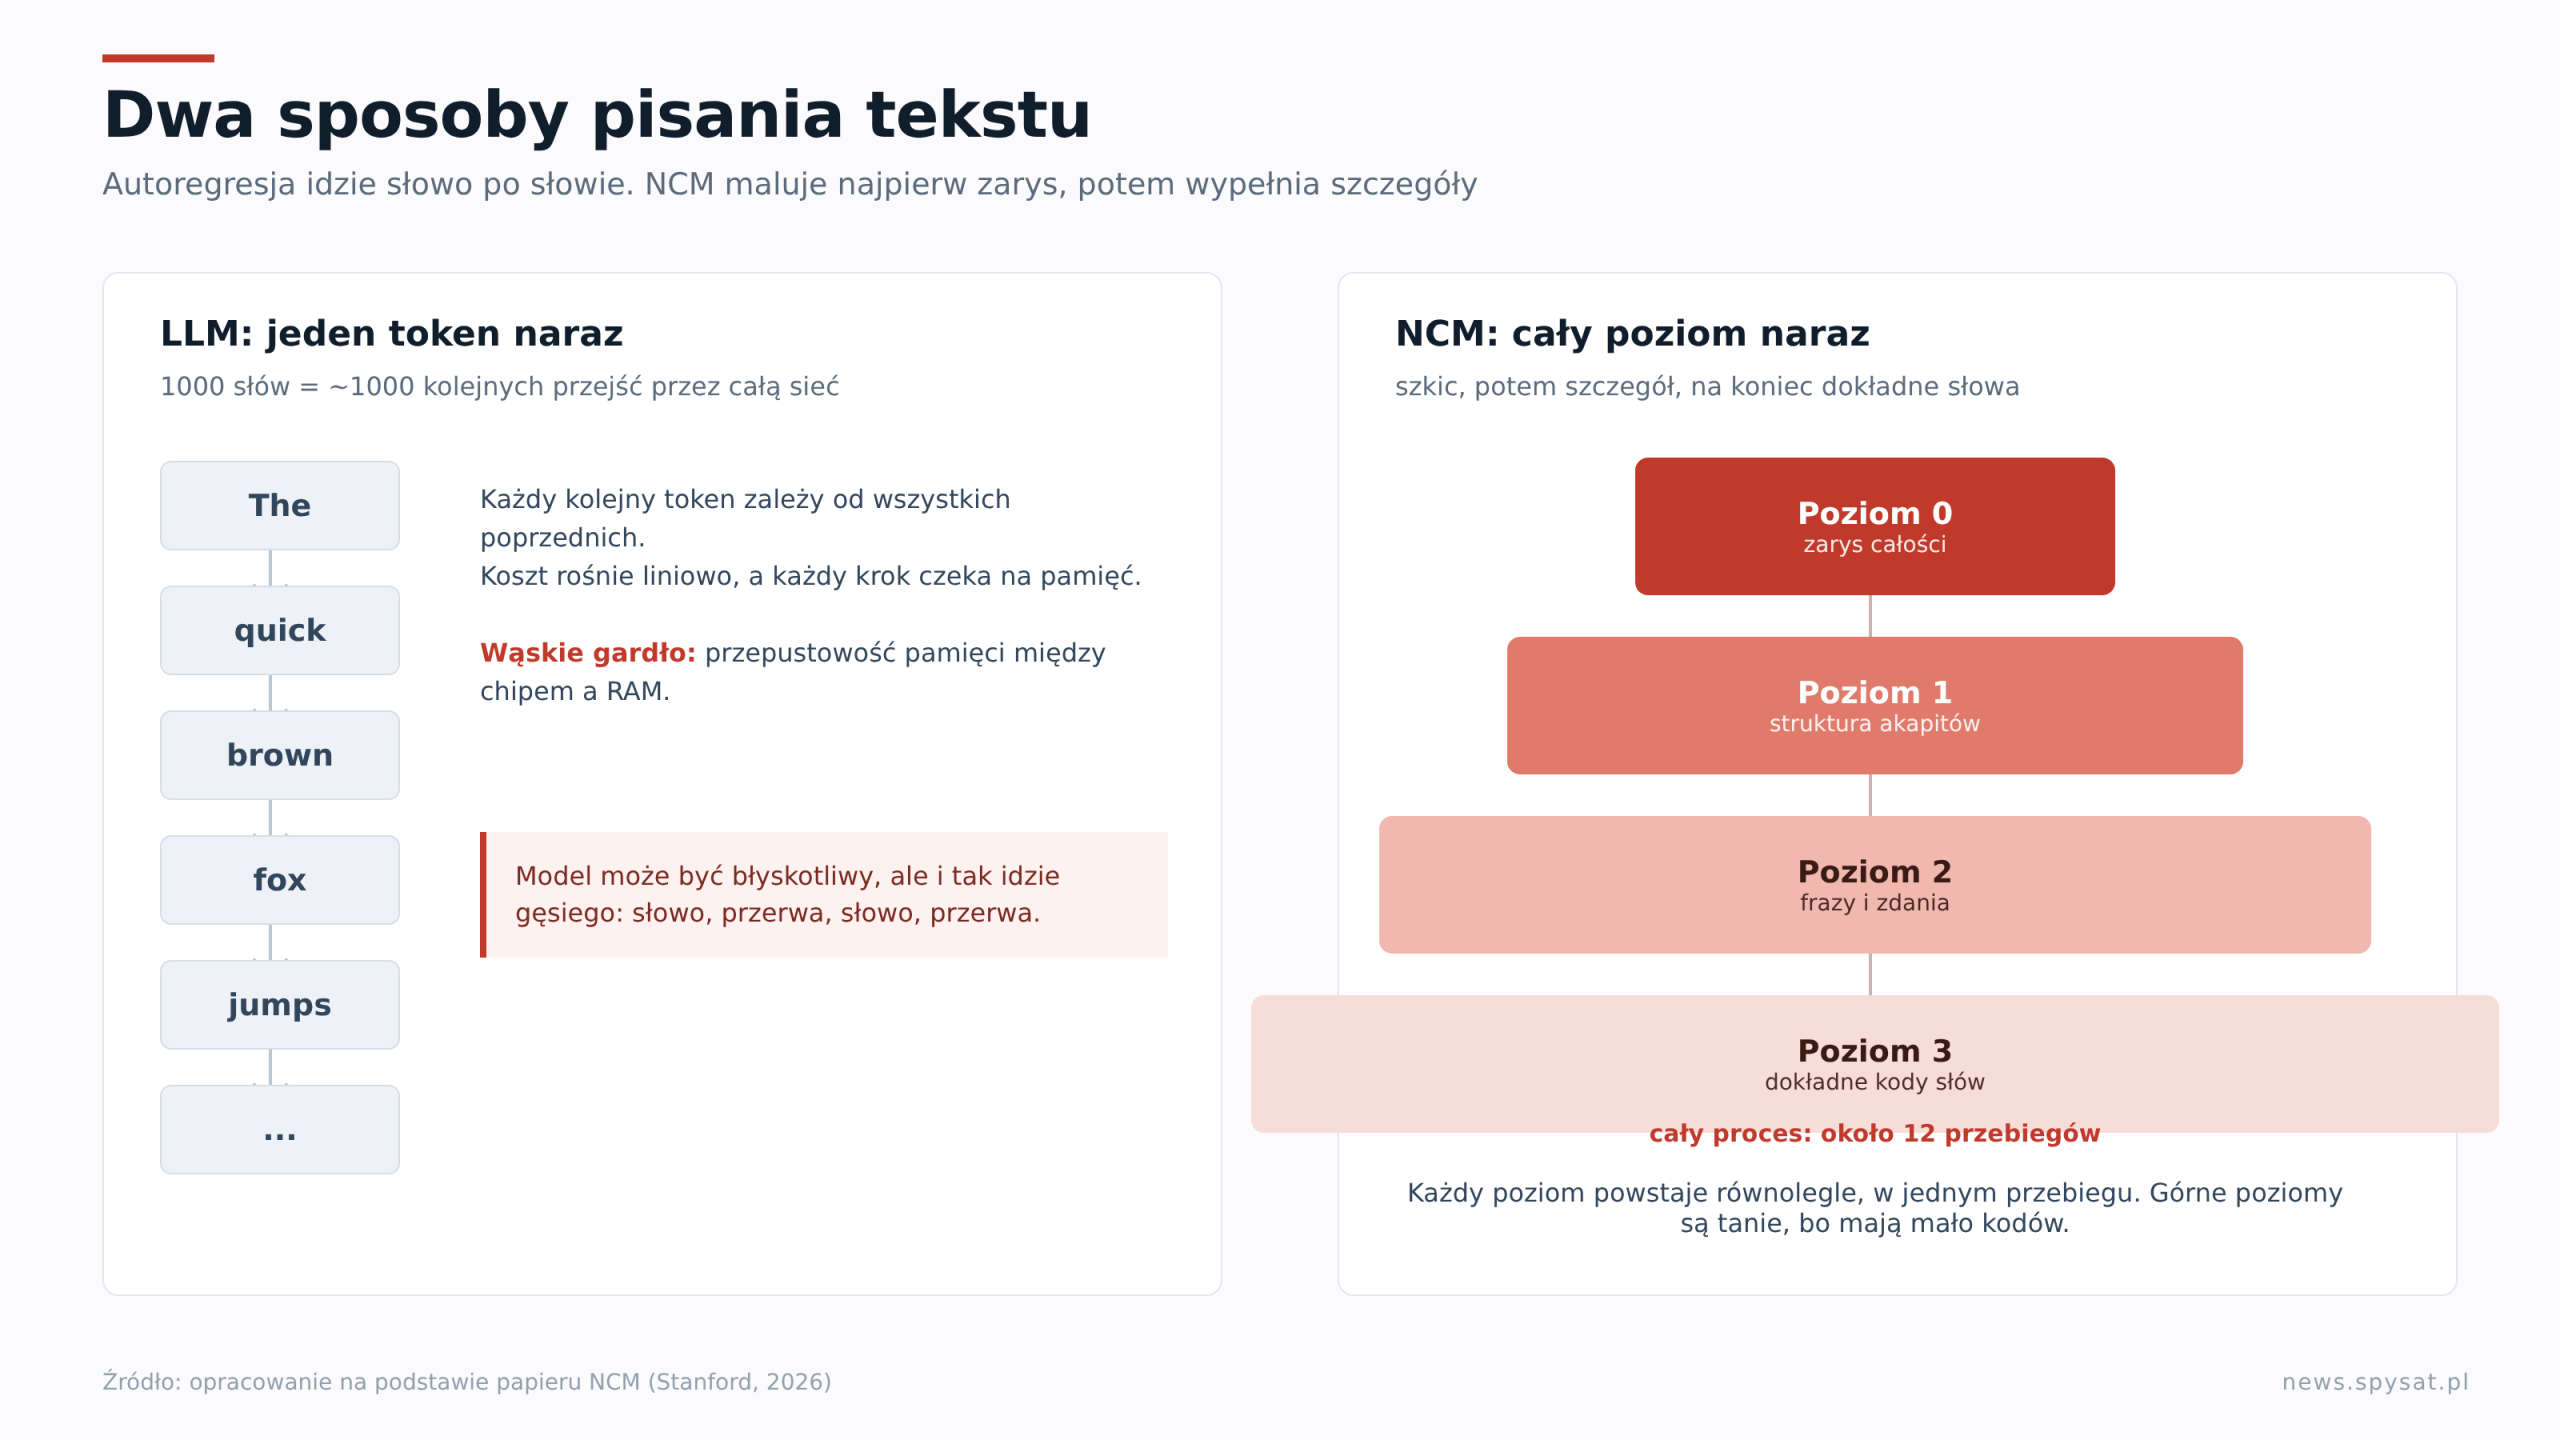
Współczesne modele językowe działają autoregresyjnie. Przewidują jeden token, czyli słowo albo fragment słowa, wrzucają go z powrotem do modelu i przewidują następny. Odpowiedź na tysiąc słów to około tysiąca kolejnych przejść przez całą sieć neuronową.
Można to porównać do genialnego pisarza, któremu wolno odłożyć tylko jedno słowo, ale po każdym słowie musi przejść przez halę magazynową po następną literę. Pisarz może być bardzo szybki, ale przejście przez betonową posadzkę zajmuje czas. W komputerach tą posadzką jest przepustowość pamięci, czyli szybkość przesyłania danych między chipem a kośćmi RAM.
Nawet z tym hamulcem ilość syntetycznego tekstu eksplodowała. W maju 2024 roku Google przetwarzał 9,7 biliona tokenów miesięcznie. Rok później było to 480 bilionów. W maju 2026 roku klienci Google Cloud przekraczali 3,2 biliarda tokenów rocznie, a ponad 375 firm generowało po ponad bilion tokenów każda.
Inżynierowie próbowali obejść ograniczenie modelami dyfuzyjnymi, które zaczynają od strony szumu i czyszczą cały tekst równolegle. Problem w tym, że dyfuzja wymagała kilkudziesięciu przejść przez całą stronę, a zmniejszenie ich liczby psuło jakość. Wąskie gardło trzymało się mocno.
Czym jest NCM
9 października 2026 roku laboratorium Hazy Research na Stanfordzie opublikowało papier „Next Concept Modeling: Fast, Parallel, Coarse-to-Fine Text Generation”. Pracę współprowadzili Hermann Kumbong, doktorant ze Stanforda, i Ishan S. Khare. W zespole byli też Iddah Mlauzi, Andrew Woen, Charles Ding, E. Kelly Buchanan, Simran Arora, Azalia Mirhoseini, współtwórczyni AlphaChip, oraz Christopher Re, szef laboratorium Hazy Research. Badanie powstało we współpracy z Together AI.
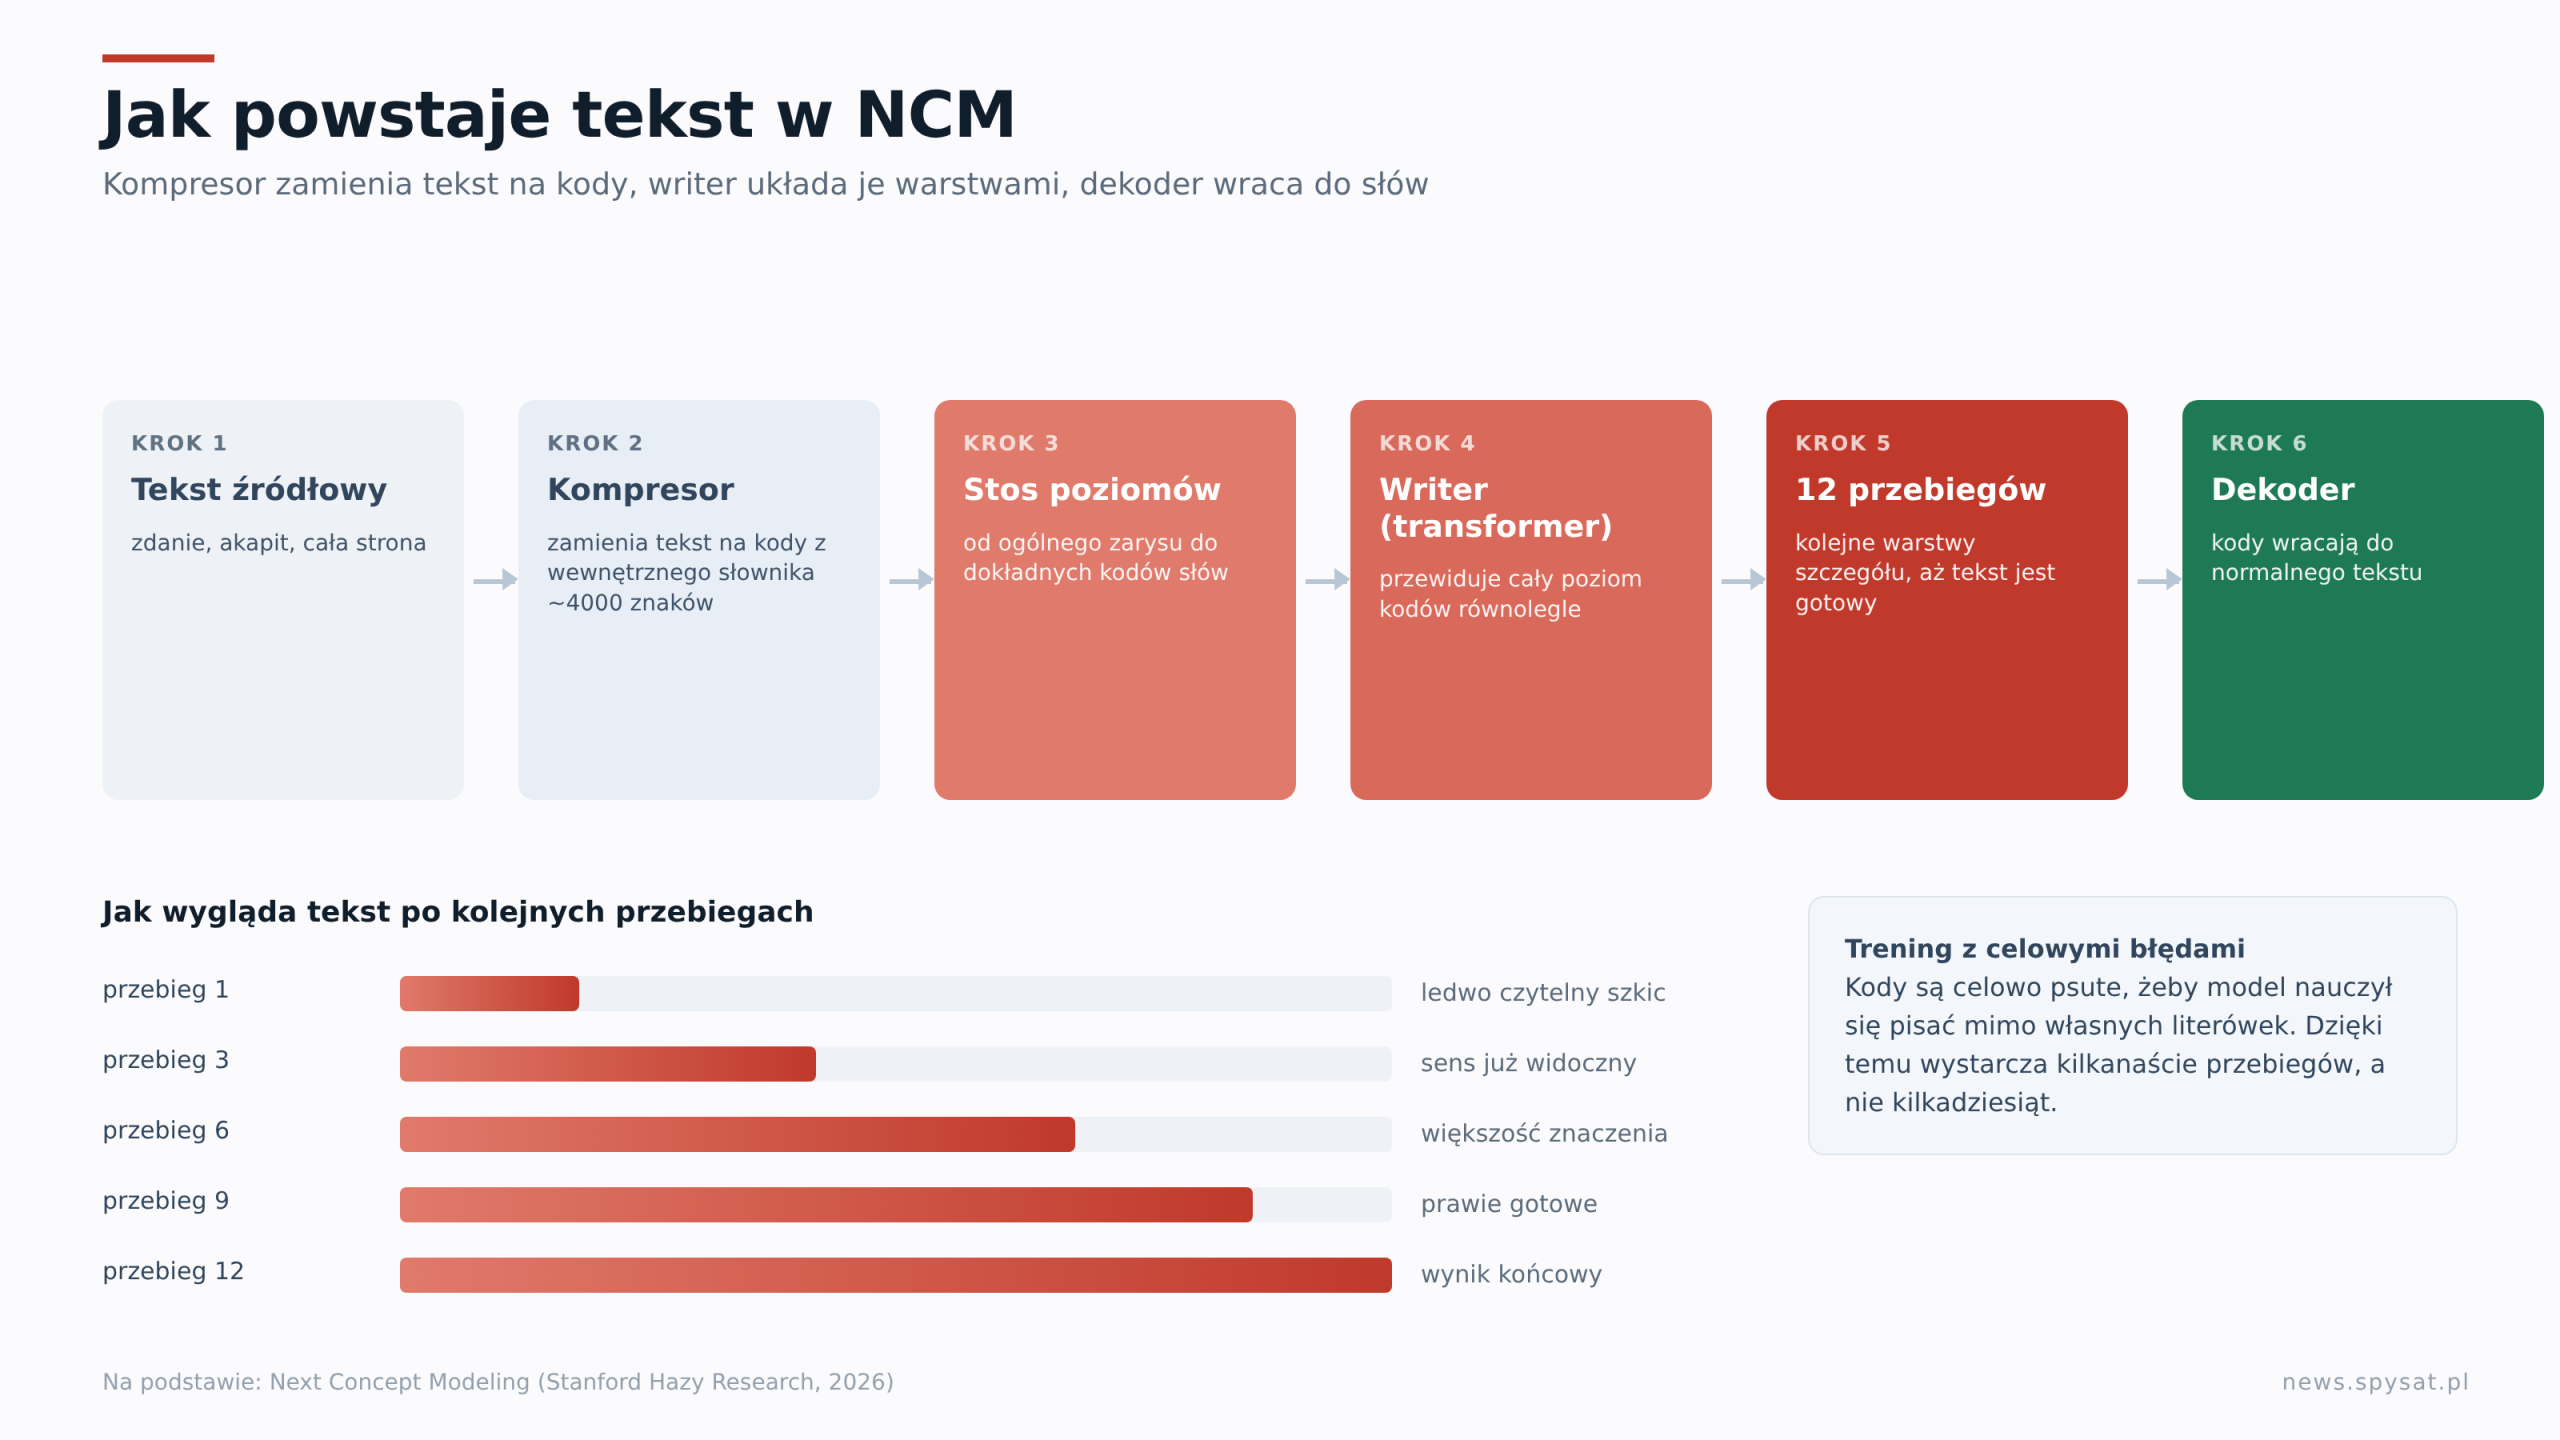
Zamiast przewidywać słowo po słowie, NCM generuje tekst tak, jak malarz maluje scenę. Najpierw tokenizator, czyli wieloskalowy model resztkowy VQ-VAE, zamienia fragment tekstu na stos poziomów hierarchii. Każdy poziom ma własny słownik około 4 tysięcy kodów maszynowych. Najwyższy poziom to rozmyty zarys całego fragmentu. Każdy poziom niżej dodaje szczegół, aż na dole pojawiają się dokładne kody poszczególnych słów.
Potem zwykły transformer, nazywany writerem, przewiduje cały poziom kodów jednocześnie. Najpierw powstaje szkic struktury całej strony, potem model schodzi poziom po poziomie i wypełnia dokładne słowa. Ponieważ wczesne poziomy są małe, pierwsze przebiegi są obliczeniowo tanie. Model uczono dodatkowo tak, żeby celowo psuć kody w trakcie treningu. Dzięki temu nauczył się pisać mimo własnych literówek i domyka cały tekst w kilkunastu przebiegach, a w testach na sudoku wystarczało mu dwanaście ewaluacji funkcji.
Widać tu zasadniczą różnicę. Autoregresja to łańcuch zależności, w którym każdy krok czeka na poprzedni. NCM to kilka warstw, z których każda może powstać równolegle, a szczegół pojawia się dopiero wtedy, gdy zarys już istnieje.
Co pokazały testy
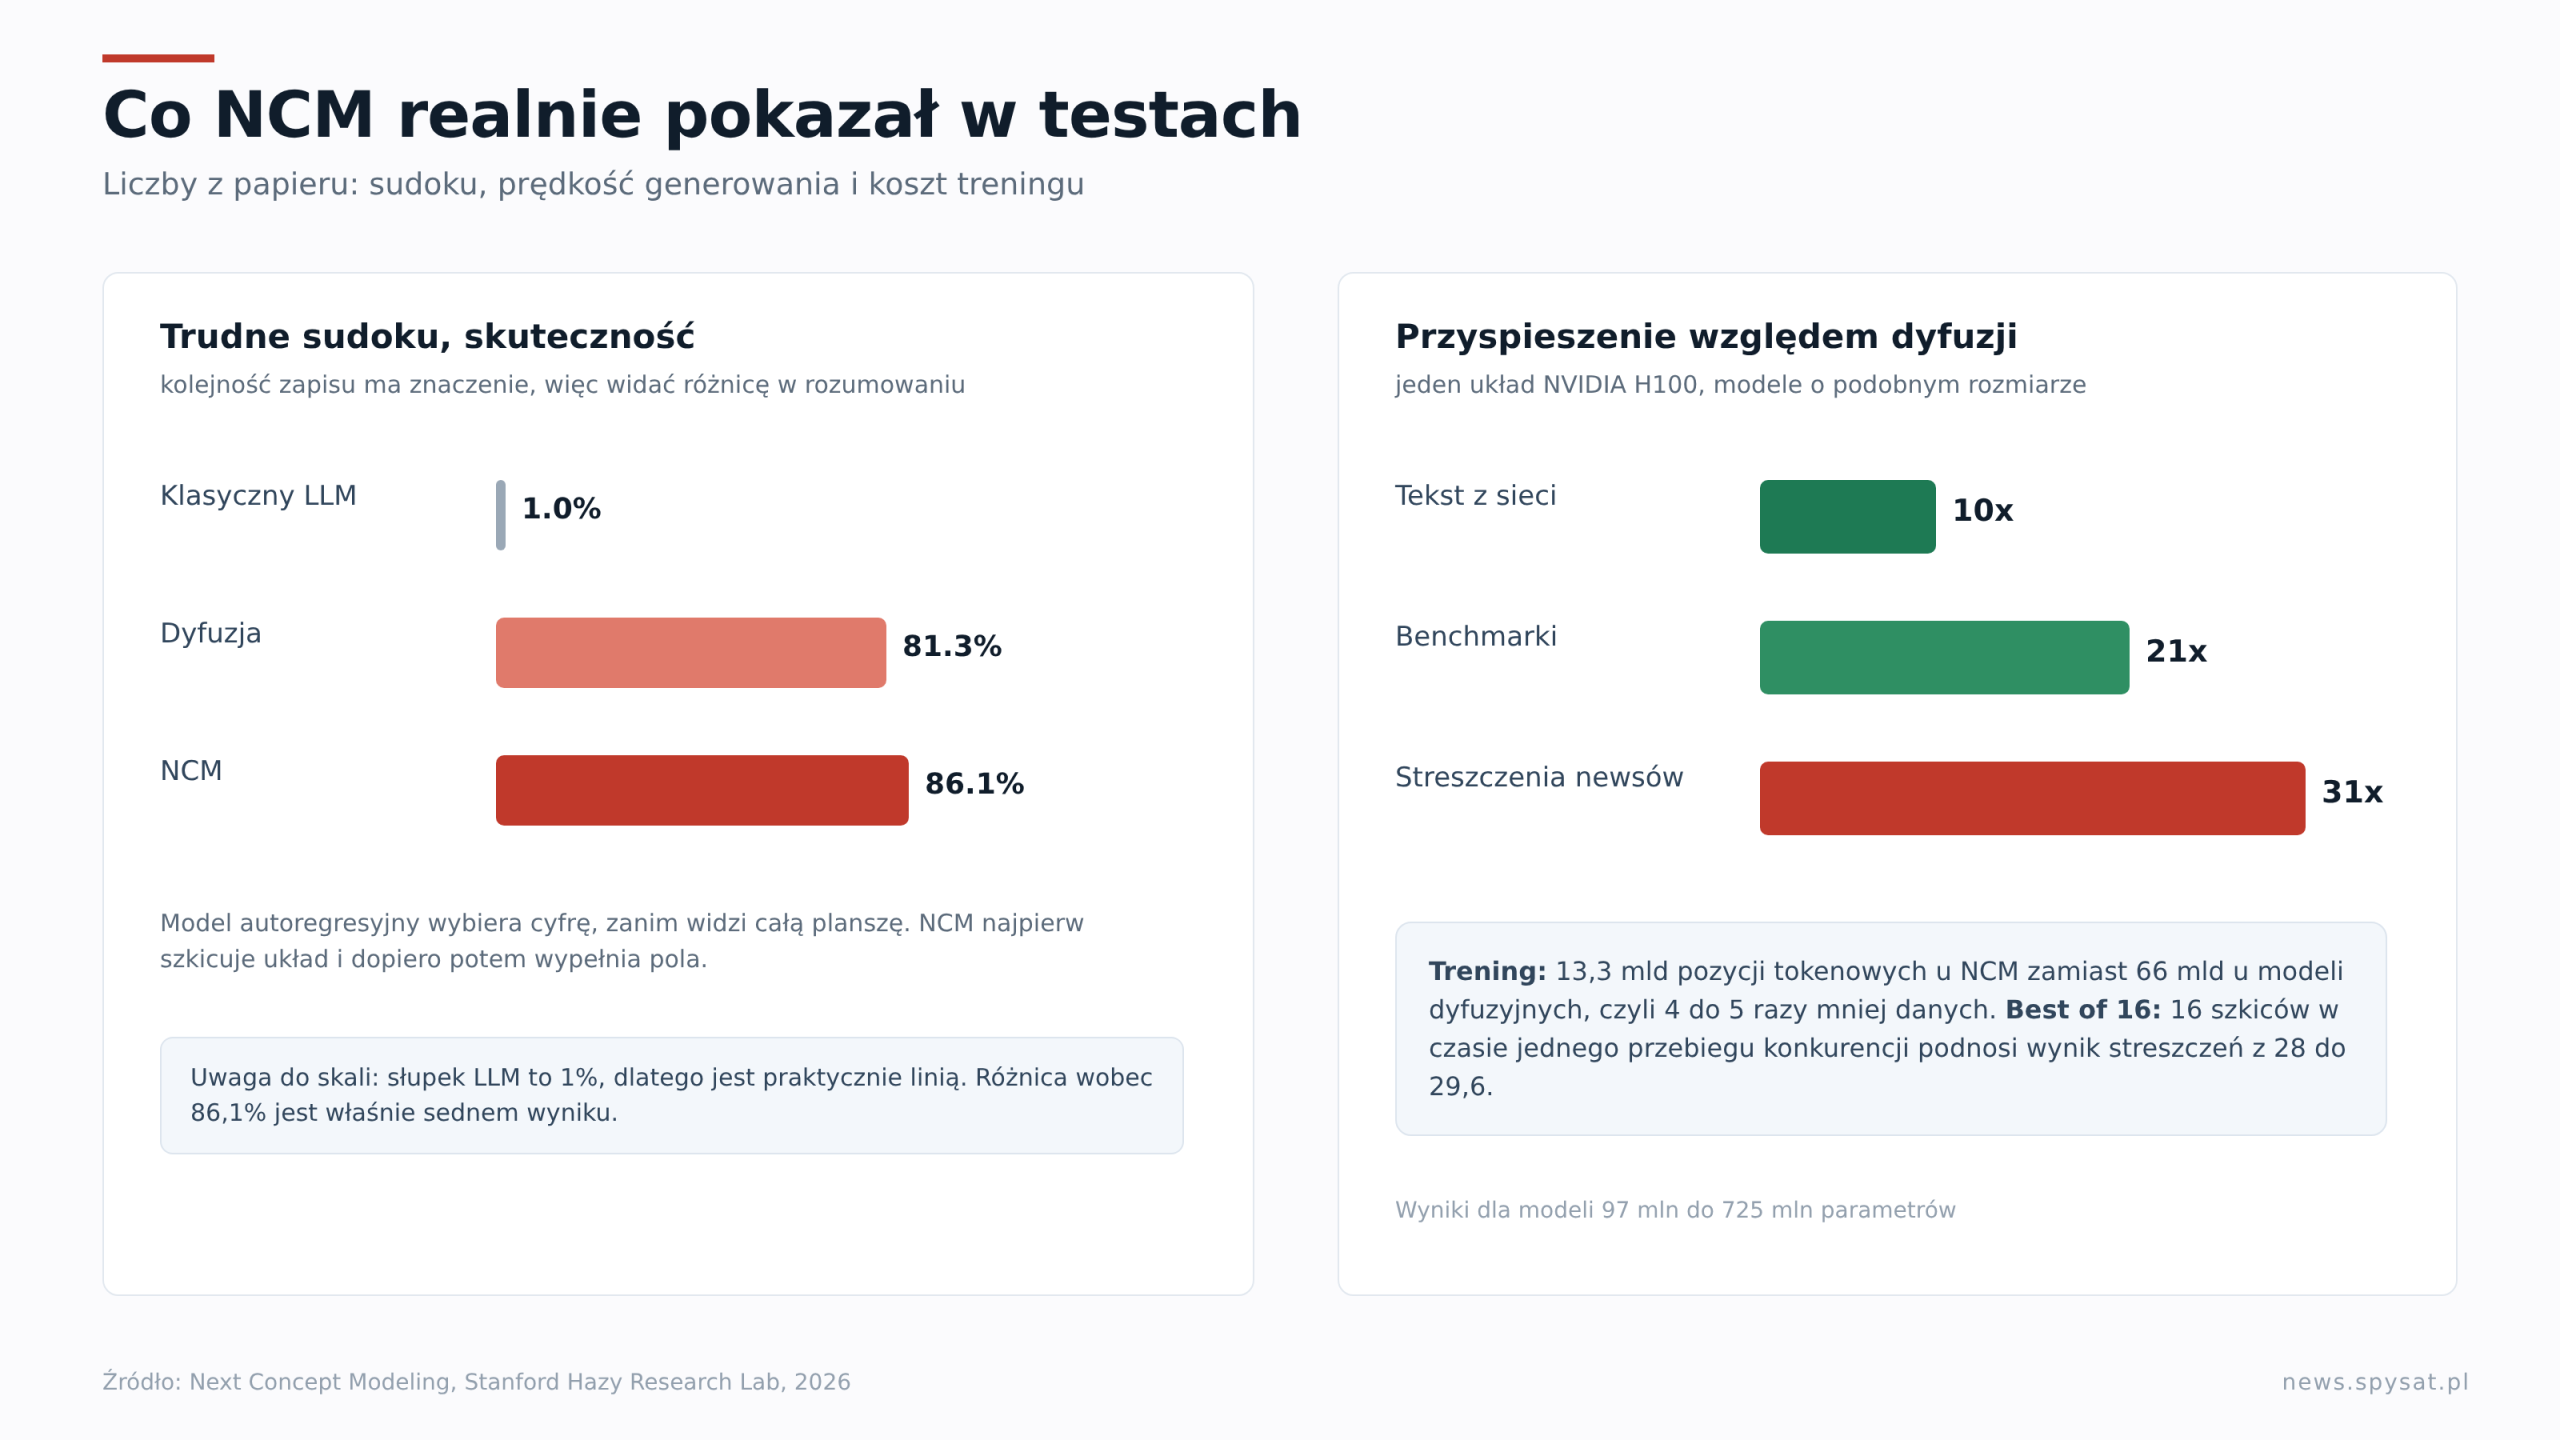
Najbardziej sugestywny wynik nie dotyczył wcale pisania artykułów, tylko sudoku. Modele słowo po słowie rozwiązały zaledwie 1 procent trudnych plansz, bo wybór cyfry na początku, bez widoku całej planszy, prowadzi donikąd. Najlepszy model dyfuzyjny w tym zestawieniu, FMLM+, rozwiązał 81,3 procent plansz, a NCM 86,1 procenta. Dla porządku: zwykła dyfuzja typu MDLM zatrzymała się na 30,2 procenta, a model DUO na 58,4 procenta. Przewaga wynika z kolejności: NCM najpierw szkicuje cały układ, a dopiero potem wypełnia pola.
Podobnie wyglądało tłumaczenie z niemieckiego na angielski. Po pierwszym przebiegu tekst jest ledwo czytelny. Po szóstym widać większość znaczenia. Po jedenastym wynik osiąga 77,8 punktu, czyli prawie idealne dopasowanie do tłumaczenia referencyjnego.
Na pojedynczym układzie NVIDIA H100 NCM był 21 razy szybszy od najlepszych modeli dyfuzyjnych o podobnym rozmiarze przy generowaniu bezwarunkowym na zbiorze LM1B, 10 razy szybszy na OpenWebText i 31 razy szybszy przy streszczeniach w zbiorze XSum. Co ważniejsze, osiągał to, ucząc się na około pięć razy mniejszej liczbie danych: 13,36 miliarda pozycji tokenowych razem z tokenizatorem zamiast 66 miliardów u konkurencji.
Był jeszcze efekt, który rozgrzał dyskusje w branży. Skoro generowanie jest tak szybkie, model może w czasie jednego przebiegu konkurencji przygotować szesnaście pełnych kandydatów i wybrać najlepszego metodą Minimum Bayes Risk. Na streszczeniach XSum podniosło to wynik ROUGE-L do 29,6, a na tłumaczeniu WMT14 dało 25,2 BLEU.
Herman Kumbong mówił w wywiadach, że NCM działa 6 do 10 razy szybciej niż modele słowo po słowie, a przewaga rośnie wraz z długością tekstu.
Czym NCM różni się od klasycznego LLM
- Kolejność pracy. LLM pisze sekwencyjnie, token po tokenie. NCM najpierw tworzy zarys całości, a potem zagęszcza szczegół.
- Równoległość. W LLM każdy token czeka na poprzedni. W NCM cały poziom kodów powstaje w jednym przebiegu.
- Koszt. Wczesne poziomy NCM są tanie, bo zawierają mało kodów. W LLM koszt każdego kroku jest podobny, bo za każdym razem przechodzi się przez całą sieć.
- Sposób myślenia o strukturze. LLM podejmuje decyzje lokalnie i nie widzi całości, dopóki jej nie dopisze. NCM od początku pracuje na szkicu całego tekstu.
- Reprezentacja. LLM operuje na tokenach z publicznego słownika. NCM operuje na hierarchii własnych kodów, po około 4 tysiące na poziom, których nikt z zewnątrz nie czyta.
- Dojrzałość. LLM to architektura przetestowana w skali setek miliardów parametrów. NCM to na razie modele badawcze od 97 do 725 milionów parametrów.
Gdzie NCM na razie zawodzi
Papier nie jest zapowiedzią końca dużych modeli. To eksperyment na małą skalę i sami autorzy tego nie ukrywają. Nie wiadomo, czy przewaga prędkości przetrwa skalowanie do modeli wielomiliardowych.
Niezależne testy laboratorium Mind Studio pokazały zresztą poważny problem praktyczny. NCM był czterokrotnie szybszy przy pojedynczych żądaniach, ale przy przetwarzaniu partii 64 żądań jednocześnie klasyczne modele słowo po słowie wysunęły się na prowadzenie. Centra danych żyją z batchowania, więc to nie jest drobiazg.
Do tego NCM nie był testowany na złożonym kodzie programistycznym, zaawansowanej matematyce ani wieloetapowej logice. A to właśnie tam przewaga „najpierw szkic, potem szczegół” mogłaby być najciekawsza.
Jest też problem zrozumiałości. Plan wysokiego poziomu powstaje w wewnętrznym języku kodów, którego nie zna żaden człowiek. Rozumowanie maszyny dzieje się w pokoju bez okien, a na zewnątrz widać tylko wynik. Testy pokazały przy tym, że kompresor czasem zamienia konkretne nazwiska, daty albo liczby przy tłumaczeniu tekstu na kody i z powrotem. W odpowiedzi czatu to drobiazg. W zautomatyzowanym obiegu płatniczym, medycznym albo prawnym to katastrofa.
Skutki dla świata
Pierwszy skutek jest prosty: szybkość i koszt są prawdziwym mnożnikiem, nie sama inteligencja. Dane Epoch AI pokazują, że cena osiągnięcia ustalonego poziomu jakości AI spada od 50 do 200 razy rocznie. Kiedy koszt spada, użycie nie stoi w miejscu, tylko eksploduje. Jeśli generowanie tekstu przyspieszy 10 do 30 razy, agenci nie będą tylko szybciej odpowiadać. Będą wykonywać wieloetapowe zadania w tempie, którego żaden zespół ludzki nie zdoła przejrzeć.
Drugi skutek dotyczy kolejek i dostępu do dóbr. Telemetria firm chroniących wydarzenia masowe pokazuje, że w kolejkach po bilety na duże koncerty i mecze ludzie już są mniejszością, a 41 procent złośliwych botów podszywa się pod zwykłą przeglądarkę Chrome. Jeśli te boty zaczną planować 10 do 30 razy szybciej, człowiek nie przegra z mądrzejszym przeciwnikiem, tylko z tłumem, który dokończy transakcję, zanim ktoś zdąży kliknąć.
Trzeci skutek to degradacja treści, znana jako zapadanie się modeli. Badania opublikowane w Nature pokazały, że gdy modele trenowane są rekurencyjnie na tekście wygenerowanym przez wcześniejsze modele, ich wiedza się rozmywa, a po kilku generacjach odpowiedzi potrafią zamienić się w powtarzalny bełkot. Eksperci z Epoch AI szacują, że publiczne zasoby tekstu pisanego przez ludzi wyczerpią się między 2026 a 2032 rokiem. Internet Archive zauważa, że wraz z rozprzestrzenianiem się tekstu wspomaganego maszynowo pisanie w sieci staje się mniej zróżnicowane i jednolicie optymistyczne. Selena Deckelmann z Wikimedia Foundation mówi wprost, że ludzkie słowa zaczyna się traktować jak ograniczony surowiec naturalny.
Czwarty skutek jest mniej oczywisty, ale długofalowo najważniejszy. Jeśli zbudowanie wyspecjalizowanego silnika tekstowego stanieje czterokrotnie, syntetyczna treść zaleje sieć jeszcze szybciej i przyspieszy pętlę, która psuje przyszłe modele. W tym wyścigu przewaga nie idzie do tego, kto napisze więcej, ale do tego, kto ma dostęp do tekstu, którego nikt nie wygenerował.
Ciekawy przykład z mediów, z których pochodzi ta redakcja: Holik Studios publicznie chwali się, że około 90 procent pracy operacyjnej przeniosło na automatyzację. Jej agenci mają własne numery telefonów i własne skrzynki mailowe, a negocjacje stawek reklamowych prowadzą w sieci równolegle, w tempie, którego nie utrzyma klasyczny zespół handlowy. Szczegóły zostają za kulisami, ale kierunek widać wyraźnie: to nie chatbot odpowiadający na pytania, tylko zespół, który sam szuka wydawców, pisze, wysyła i czeka na odpowiedź.
Co to znaczy dla rynku i dla nas
NCM nie jest jeszcze produktem. To sygnał, że fundament, na którym tech giganci budują setki miliardów dolarów infrastruktury, czyli założenie „model pisze jedno słowo naraz”, przestał być oczywistością. Po jednej stronie stoją centra danych, elektrownie i chipsety projektowane pod autoregresję. Po drugiej doktorant z Kamerunu i kilku badaczy ze Stanforda, którzy na jednym chipie sprawdzili, czy to założenie aby na pewno jest słuszne.
Dla wydawców, sklepów i platform oznacza to jedno: obrona przed botami oparta tylko na blokowaniu adresów IP i limitach tempa będzie coraz mniej skuteczna. Cloudflare już buduje opłaty za pobieranie danych przez komercyjne crawlery, a firmy bezpieczeństwa przechodzą od blokowania do zarządzania zachowaniem kont: patrzą nie na to, skąd przychodzi żądanie, ale co konkretnie robi zautomatyzowane konto.
Dla ludzi najciekawszy jest jednak wątek, od którego zaczął się cały tekst. Matthew Prince ostrzega, że w ciągu pięciu lat ruch botów może przewyższyć ruch ludzi tysiąc do jednego. To się nie rozstrzygnie wyłącznie w algorytmach. Rozstrzygnie się w tym, ile autentycznych słów napisanych przez ludzi zostanie w sieci i czy ktokolwiek będzie jeszcze umiał je odróżnić.
Źródła
- Next-Concept Modeling: Fast, Parallel Coarse-to-Fine Text Generation, arXiv:2610.14162, 9 października 2026: https://arxiv.org/abs/2610.14162
- Blog Hazy Research, 12 października 2026: https://hazyresearch.stanford.edu/blog/2026-10-12-ncm
- Kod i wagi modeli: https://github.com/HazyResearch/ncm
- Transkrypt omówienia wideo: https://www.youtube.com/watch?v=o8zuaPbbaGU
O autorze

Piotr Kurowski: badacz i inżynier sztucznej inteligencji, zajmuje się uczeniem maszynowym i sieciami neuronowymi. Prowadzi badania w OpenAI, wcześniej w polskim startupie AI i Google AI. Analityczny umysł, introwertyk typu INTJ. Objaśnia złożoność modeli AI w sposób zrozumiały dla każdego.