HolikStudios Media Group - https://holikstudios.com
Prawdziwa ekonomia centrów danych AI
Gdyby ktoś dziś chciał wejść w biznes infrastruktury AI, naturalny pomysł brzmi: kupić jeden klaster, powiedzmy osiem akceleratorów H200, i sprzedawać moc obliczeniową. Pytanie, które naprawdę się liczy, nie dotyczy jednak technologii ani nawet wielkości inwestycji. Brzmi ono: czy taki jednoosobowy biznes w ogóle ma szansę się zwrócić i kiedy?
Ten artykuł to próba policzenia tego uczciwie, jak w analizie finansowej. Punktem odniesienia są twarde dane z września 2026 roku, w tym udokumentowana sesja agenta AI, która wykonała pełny dzień pracy za 6,25 dolara. Dużych graczy, Amazona i Microsoft, zostawiamy na koniec, bo ich liczby pokazują wyłącznie skalę rynku, a nie odpowiedź na pytanie o opłacalność małego podmiotu.
Ten sam model, różne ceny
Zacznijmy od faktu, który porządkuje całą resztę. Ten sam model, DeepSeek-V4.1-Flash, można uruchomić na trzy sposoby: lokalnie na własnym sprzęcie, przez oficjalne API DeepSeeka albo u pośredników, którzy hostują jego otwarte wagi. Cena dokładnie tego samego tokenu różni się przy tym nawet stukrotnie.
| Ścieżka | Wejście / 1 mln | Wyjście / 1 mln | Cache |
|---|---|---|---|
| Lokalnie, własny węzeł 8x H200 | 0,011 USD (koszt własny) | – | – |
| Oficjalne API DeepSeek, off-peak | 0,15 USD | 0,60 USD | 0,003 USD |
| Oficjalne API DeepSeek, szczyt | 0,30 USD | 1,20 USD | 0,006 USD |
| DeepSeek, tryb batch | 0,112 USD | 0,336 USD | – |
| DeepSeek przez OpenRouter | od 0,02 USD (typowo 0,15) | 0,60 USD | – |
| Gemini 3.1 Pro (Google) | 1,50 USD | 9,00 USD | – |
| Claude Opus 5.5 (Anthropic) | 4,00 USD | 20,00 USD | 0,20 USD |
| GPT-5.6 Sol (OpenAI) | 4,00 USD | 20,00 USD | – |
| Claude Fable 5 (Anthropic) | 10,00 USD | 50,00 USD | – |
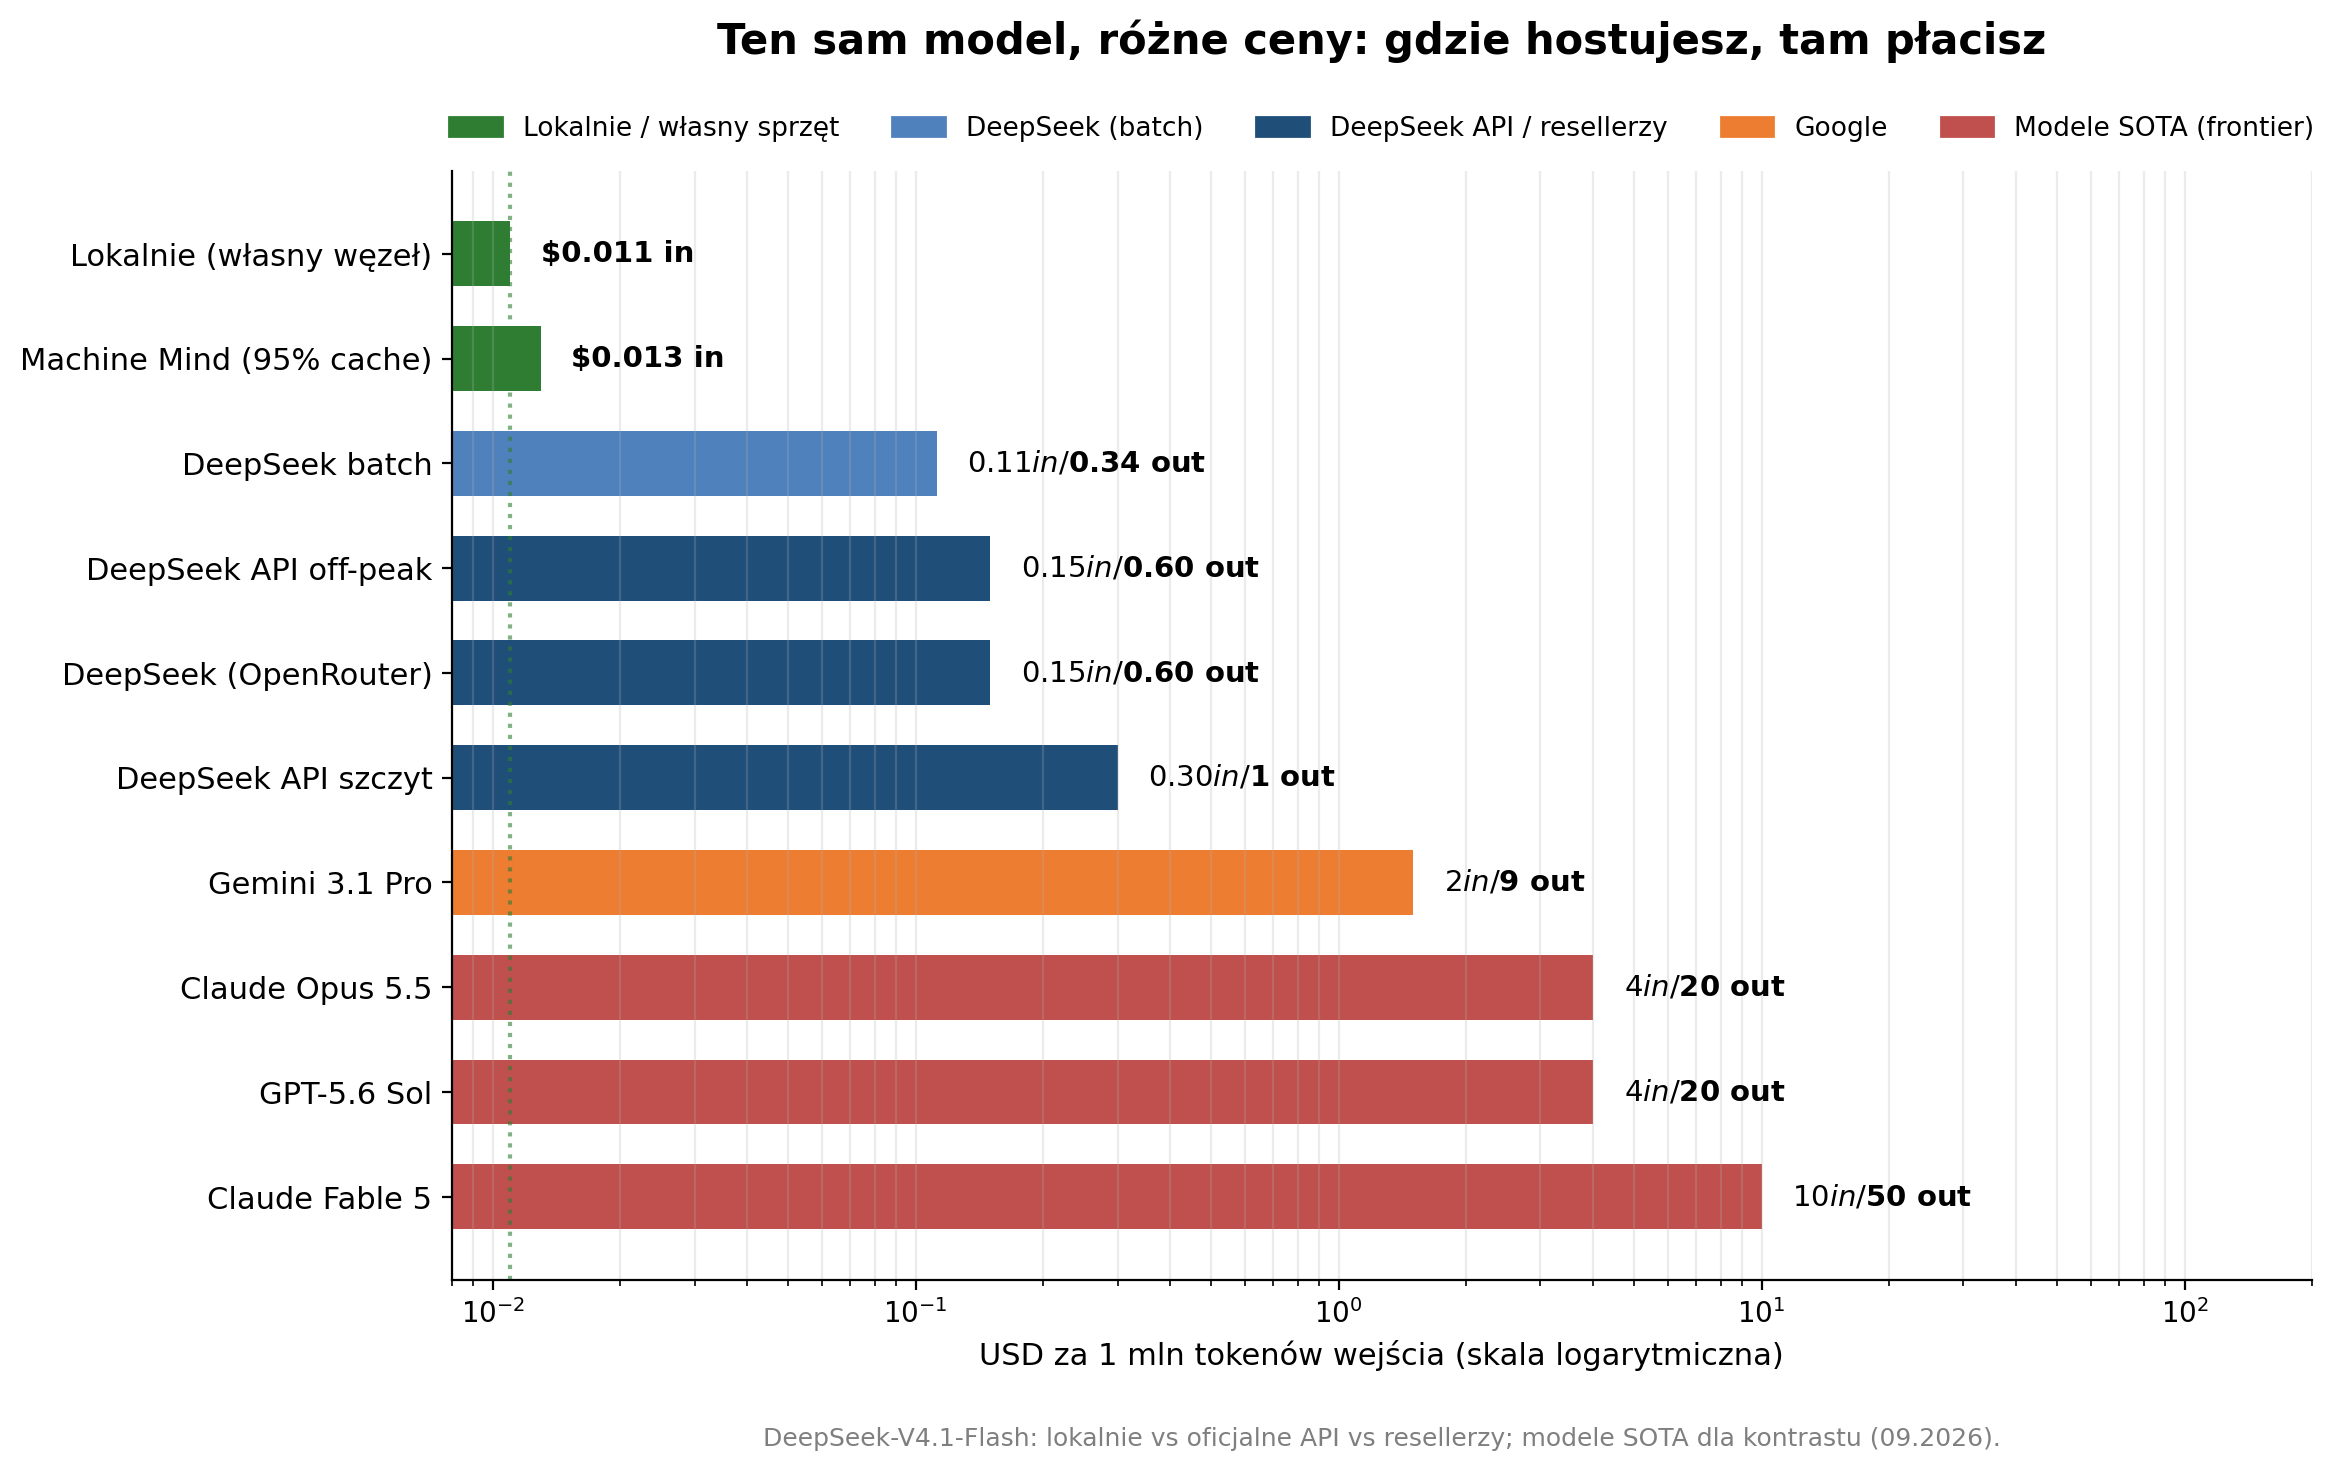
Widać tu trzy poziomy. Lokalny koszt wytworzenia to podłoga, ok. 0,011 USD za 1 mln tokenów. Cena API to ta sama podłoga plus marża dostawcy. A modele SOTA to już zupełnie inny rząd wielkości, od 1,50 do 50 USD za 1 mln. Ten sam mechanizm działa też na kartach ryczałtowych: abonament Claude Pro za 20 USD czy Max za 200 USD miesięcznie daje najcięższym użytkownikom wartość API rzędu 1500-7000 USD, czyli ukryte subsydium. Rozliczenie za zużycie jest wobec kosztu uczciwe. Abonamenty nie są.
Skoro lokalna podłoga leży tak nisko, a cena API tak wysoko, pojawia się pytanie, na które ten tekst odpowiada: czy w tej luce zmieści się mały gracz z jednym klastrem?
Anatomia węzła
Skoro lokalny koszt wytworzenia tokenu jest tak niski, warto zrozumieć, co dokładnie trzeba postawić, żeby go osiągnąć. Tu wchodzą dwa pojęcia, które tłumaczą całą ekonomię tego rynku.
Pierwsze to MoE, czyli mixture of experts. DeepSeek-V4.1-Flash nie jest jednym gęstym modelem, lecz zbiorem 552 mld parametrów podzielonych na wyspecjalizowanych „ekspertów”. W każdej pojedynczej inferencji router aktywuje tylko ich niewielką część: 8 mld parametrów przy przetwarzaniu wejścia (prefill) i 16 mld przy generowaniu odpowiedzi (decode). Efekt jest taki, że model ma pojemność wielkiego mózgu, ale liczy jak mały. To właśnie dlatego koszt pojedynczego tokenu jest tak niski.
Drugie to FP8, czyli ośmiobitowa reprezentacja wag. Sprowadzenie liczb do ośmiu bitów mniej więcej o połowę zmniejsza pamięć potrzebną na sam model w porównaniu z szesnastobitową precyzją. Nawet po tej kompresji wagi DeepSeek-V4.1-Flash zajmują jednak ok. 510 GB.
I tu jest kluczowy wniosek: model w wersji FP8 wymaga ponad 600 GB pamięci VRAM (przepis vLLM mówi o ok. 614 GB). Nie zmieści się więc na pojedynczej karcie graficznej, nawet tej z 80 GB. Żeby go uruchomić, potrzebny jest cały węzeł z ośmioma akceleratorami H200 i łącznie 1 128 GB pamięci. Innymi słowy, „tani model” nie znaczy „tani sprzęt”: wejście do gry zaczyna się od urządzenia za kilkaset tysięcy dolarów.
| Parametr modelu | Wartość |
|---|---|
| Architektura | MoE, 552 mld parametrów |
| Aktywne parametry | 8 mld (prefill) / 16 mld (decode) |
| Rozmiar wag | ok. 510 GB (FP8 + FP4) |
| Wymagany VRAM (FP8, przepis vLLM) | ok. 614 GB |
| Kontekst | do 1 mln tokenów |
| KV cache | ok. 890 bajtów na token |
| Licencja | MIT |
Niski koszt wynika więc z dwóch rzeczy: małej liczby aktywowanych parametrów oraz wyjątkowo skompresowanego cache. Cache KV rzędu 890 bajtów na token sprawia, że nawet przy pełnym kontekście miliona tokenów pamięć podręczna zajmuje mniej niż 1 GB.
| Wymagania sprzętowe | Wartość (2026) |
|---|---|
| Minimalne VRAM (FP8) | ok. 614 GB |
| Typowy zestaw | 8x H200 (1 128 GB) |
| Cena pojedynczego H200 | 30 000 – 40 000 USD |
| Węzeł 8x H200 HGX (z NVLink i siecią) | 320 000 – 420 000 USD |
| Typowa cena rynkowa węzła | ok. 370 000 USD |
| Pobór mocy | ok. 700 W na GPU, 8-10 kW na węzeł |
Rachunek kosztów startupu z jednym klastrem
Policzmy prawdziwy koszt wejścia i rocznego utrzymania. To pierwszy moment, w którym większość wyobrażeń o „tanim AI” zderza się z tabelą.
| Nakład początkowy (CAPEX) | Kwota |
|---|---|
| Węzeł 8x H200 HGX (z NVLink i siecią) | 370 000 USD |
| Instalacja, okablowanie, rezerwa | 15 000 USD |
| Razem | 385 000 USD |
| Koszt roczny (OPEX) | Kwota |
|---|---|
| Kolokacja i łącze | 24 000 USD |
| Energia i chłodzenie (9 kW IT, PUE 1,4, 0,15 USD/kWh) | 16 500 USD |
| Utrzymanie i serwis | 8 000 USD |
| Obsługa (¼ etatu) | 12 000 USD |
| Razem | 60 500 USD |
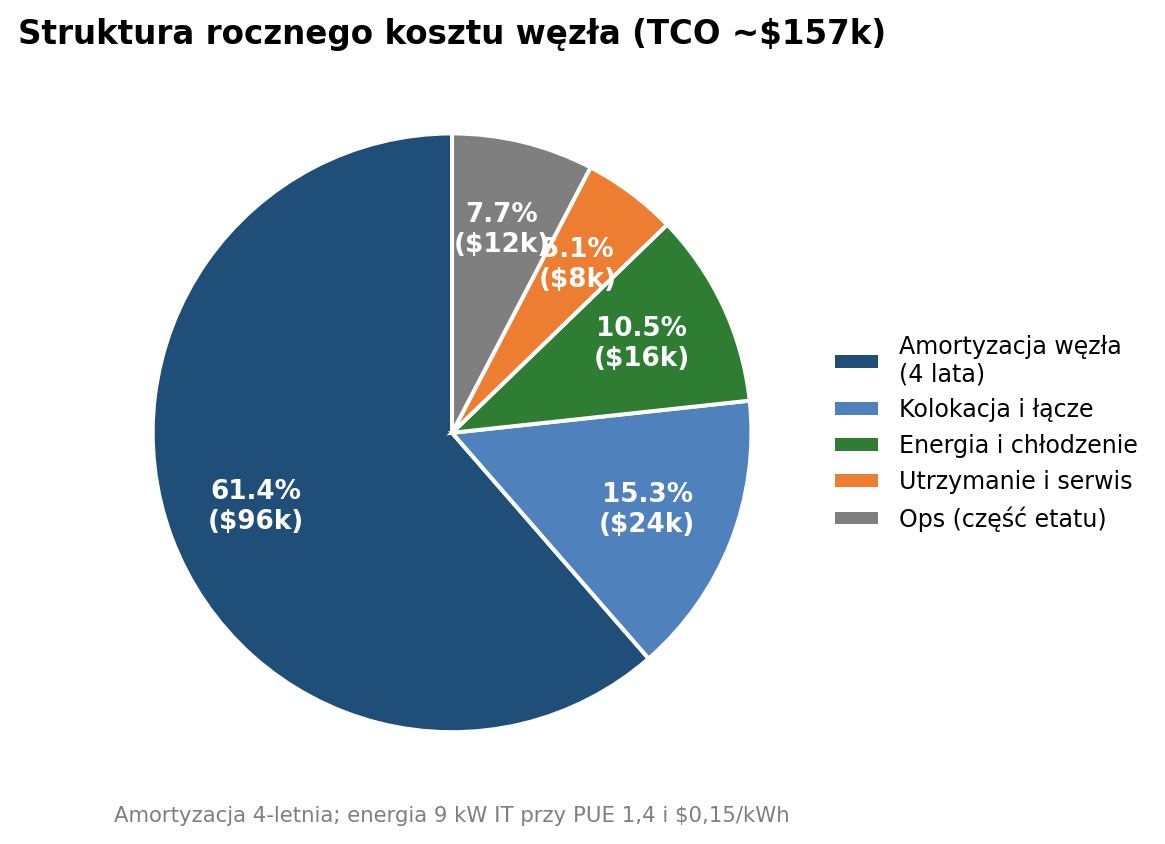
Zwróćmy uwagę na strukturę: blisko dwie trzecie rocznego kosztu to amortyzacja samego sprzętu, a dopiero dalej kolokacja. Energia, wbrew obiegowej opinii, to najmniejszy pojedynczy składnik.
Ile kosztuje wytworzenie jednego tokenu
Teraz najważniejsza liczba w całej analizie. Przyjmijmy realistyczną przepustowość węzła na poziomie 40 mld tokenów dziennie (z zakresu 30-50 mld przy 70-80% dostępności). Amortyzacja to 96,3 tys. USD rocznie, koszty operacyjne 60,5 tys., czyli razem ok. 156,8 tys. USD. Przy 14,6 bln tokenów rocznie daje to ok. 0,011 USD za 1 mln tokenów, czyli dolną krawędź z zestawienia powyżej.
Dwa modele biznesowe
Tu zaczyna się sedno. Ten sam węzeł można bowiem wykorzystać na dwa sposoby, a różnica w opłacalności jest dramatyczna.
Model A: sprzedaż mocy obliczeniowej. Sprzedajemy przetworzone tokeny po cenie zbliżonej do rynkowej, powiedzmy 0,15 USD za 1 mln. Nie budujemy produktu, tylko dostarczamy moc.
Model B: własny produkt agentowy. Węzeł pracuje na potrzeby naszego produktu, na przykład sesji agenta rozliczanej po 6,25 USD. To cena z rzeczywistego przypadku Machine Mind Ltd, opisanego 17 września 2026 roku w materiale One business day, one complete product: 479,9 mln tokenów, 95% trafień cache, koszt API 6,25 USD, czyli ok. 0,013 USD za 1 mln tokenów.
Model B brzmi atrakcyjnie jako produkt, ale jako biznes infrastrukturalny jest pułapką. Cena 0,013 USD za 1 mln jest bliska kosztowi własnemu (0,011 USD), więc marża na tokenie niemal nie istnieje. Wszystko musi zarobić się na wolumenie.
Cienkie marże i ściana
Ta jedna liczba mówi więcej niż cała reszta tekstu. Pokazuje, jak niskie są już marże na rynku tokenów i że trend jest jednokierunkowy. Cena, po jakiej da się sprzedać przetworzony token (0,013 USD), leży praktycznie na koszcie jego wytworzenia (0,011 USD). To nie jest jeszcze zysk, to ścisk. Resellerzy oferują już DeepSeeka po ok. 0,02 USD za 1 mln, czyli ledwo nad lokalną podłogą.
Wniosek jest brutalny: gdy cena zakupu u oficjalnego dostawcy zrówna się z kosztem postawienia serwera lokalnie, przestaje istnieć jakikolwiek arbitraż. W tym miejscu dochodzimy do ściany. Hostowanie modelu przestaje być biznesem, bo ponad koszt sprzętu i prądu nie ma już czego zarobić. Dla małego gracza to największe ryzyko, większe niż awaria czy wojna cenowa: sprzedaje towar, którego cena nieuchronnie zmierza do ceny jego własnego kosztu. Marże na otwartych modelach nie tyle są cienkie, ile systematycznie znikają.
Rachunek to nie wszystko
Łatwo byłoby na tym poprzestać i uznać, że lokalna inferencja nie ma sensu, bo kupno DeepSeeka przez API jest po prostu wygodniejsze i nie wymaga kapitału. Czysto rachunkowo to prawda: dla większości zastosowań API wygra. Ale kryterium kosztu nie jest jedynym, a przy pewnych zastosowaniach wcale nie jest najważniejsze.
Po pierwsze, brak zależności. Kupując od dostawcy, oddaje się kontrolę nad cennikiem, limitami, dostępnością i tym, czy i kiedy model zostanie zdeprecjonowany albo zmieniona jego polityka. Własny węzeł to brak vendor lock-in i brak ryzyka, że jutro dostawca podniesie cenę albo zablokuje dostęp.
Po drugie, prywatność. Gdy dane są wrażliwe, lokalna inferencja oznacza, że nic nie opuszcza własnej infrastruktury. Dla sektora medycznego, prawnego, finansowego czy administracji publicznej to często warunek konieczny, niezależny od tego, jak tani jest zewnętrzny API.
Po trzecie, przewidywalność: stała cena i stała wydajność. Zewnętrzny API podlega podwyżkom, wojnom cenowym i limitom zapytań na minutę. Własny sprzęt daje stały koszt niezależny od cennika dostawcy oraz przewidywalną przepustowość i opóźnienia, bez współdzielenia mocy z innymi klientami.
Lokalna inferencja jest więc słabym interesem, gdy patrzy się wyłącznie na zwrot z kapitału, i rozsądnym wyborem, gdy liczy się kontrola, poufność i przewidywalność. Rachunek ekonomiczny rzadko rozstrzyga sam.
A jednak ktoś zarabia
Warto dodać tu jeden kontrast. Gdy otwarte modele walczą na granicy kosztu, modele SOTA od zachodnich dostawców są wyceniane zupełnie inaczej: Gemini 3.1 Pro po 1,50 i 9,00 USD, Claude Opus 5.5 oraz GPT-5.6 Sol po 4,00 i 20,00 USD, a Claude Fable 5 po 10,00 i 50,00 USD za 1 mln tokenów. To setki razy więcej niż lokalny koszt DeepSeeka. Część tej ceny to oczywiście amortyzacja treningu, marka, bezpieczeństwo i wartość dla przedsiębiorstw, ale sama rozpiętość sugeruje marże gigantyczne. Rynek pęka więc na dwa światy: otwarte modele ścigające się na granicy kosztu oraz zamknięci giganci, którzy ustalają cenę według wartości, a nie kosztu.
Kiedy się zwraca
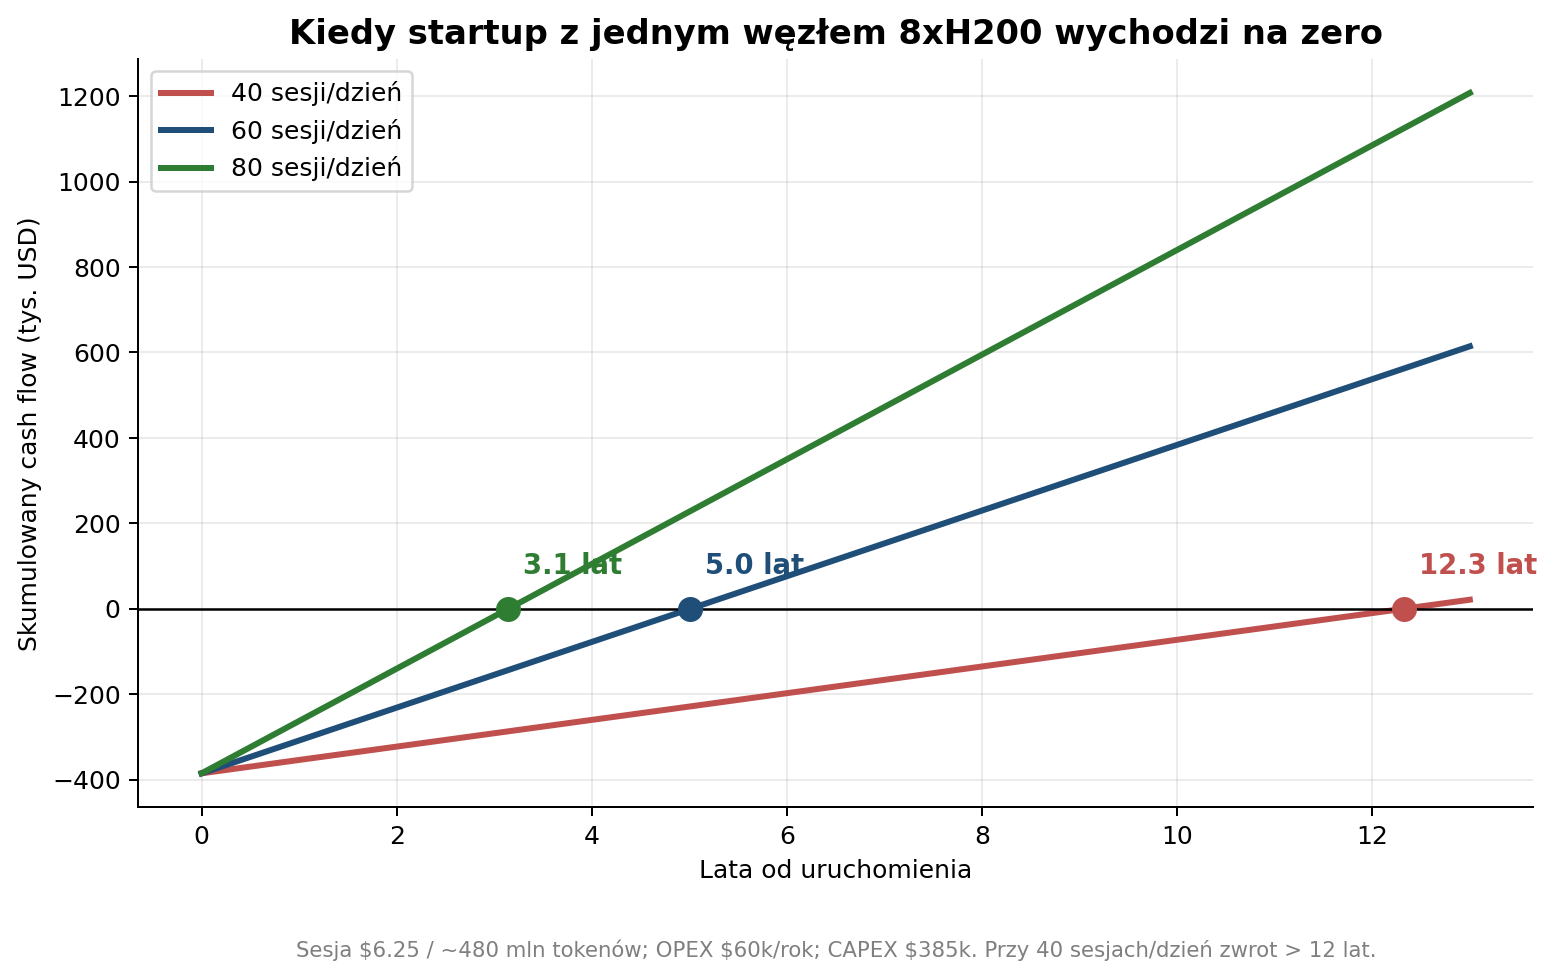
Zobaczmy, jak wygląda skumulowany cash flow w Modelu B przy trzech scenariuszach popytu. Punkt przecięcia z zerem to moment, w którym inwestycja się zwraca.
| Scenariusz | Sesje / dzień | Przychód / rok | Zysk / rok po OPEX | Zwrot (z OPEX) | Zwrot prosty |
|---|---|---|---|---|---|
| Ostrożny | 40 | 91,3 tys. | 31,3 tys. | 12,3 roku | 4,2 roku |
| Bazowy | 60 | 136,9 tys. | 76,9 tys. | 5,0 roku | 2,8 roku |
| Optymistyczny | 80 | 182,5 tys. | 122,5 tys. | 3,1 roku | 2,1 roku |
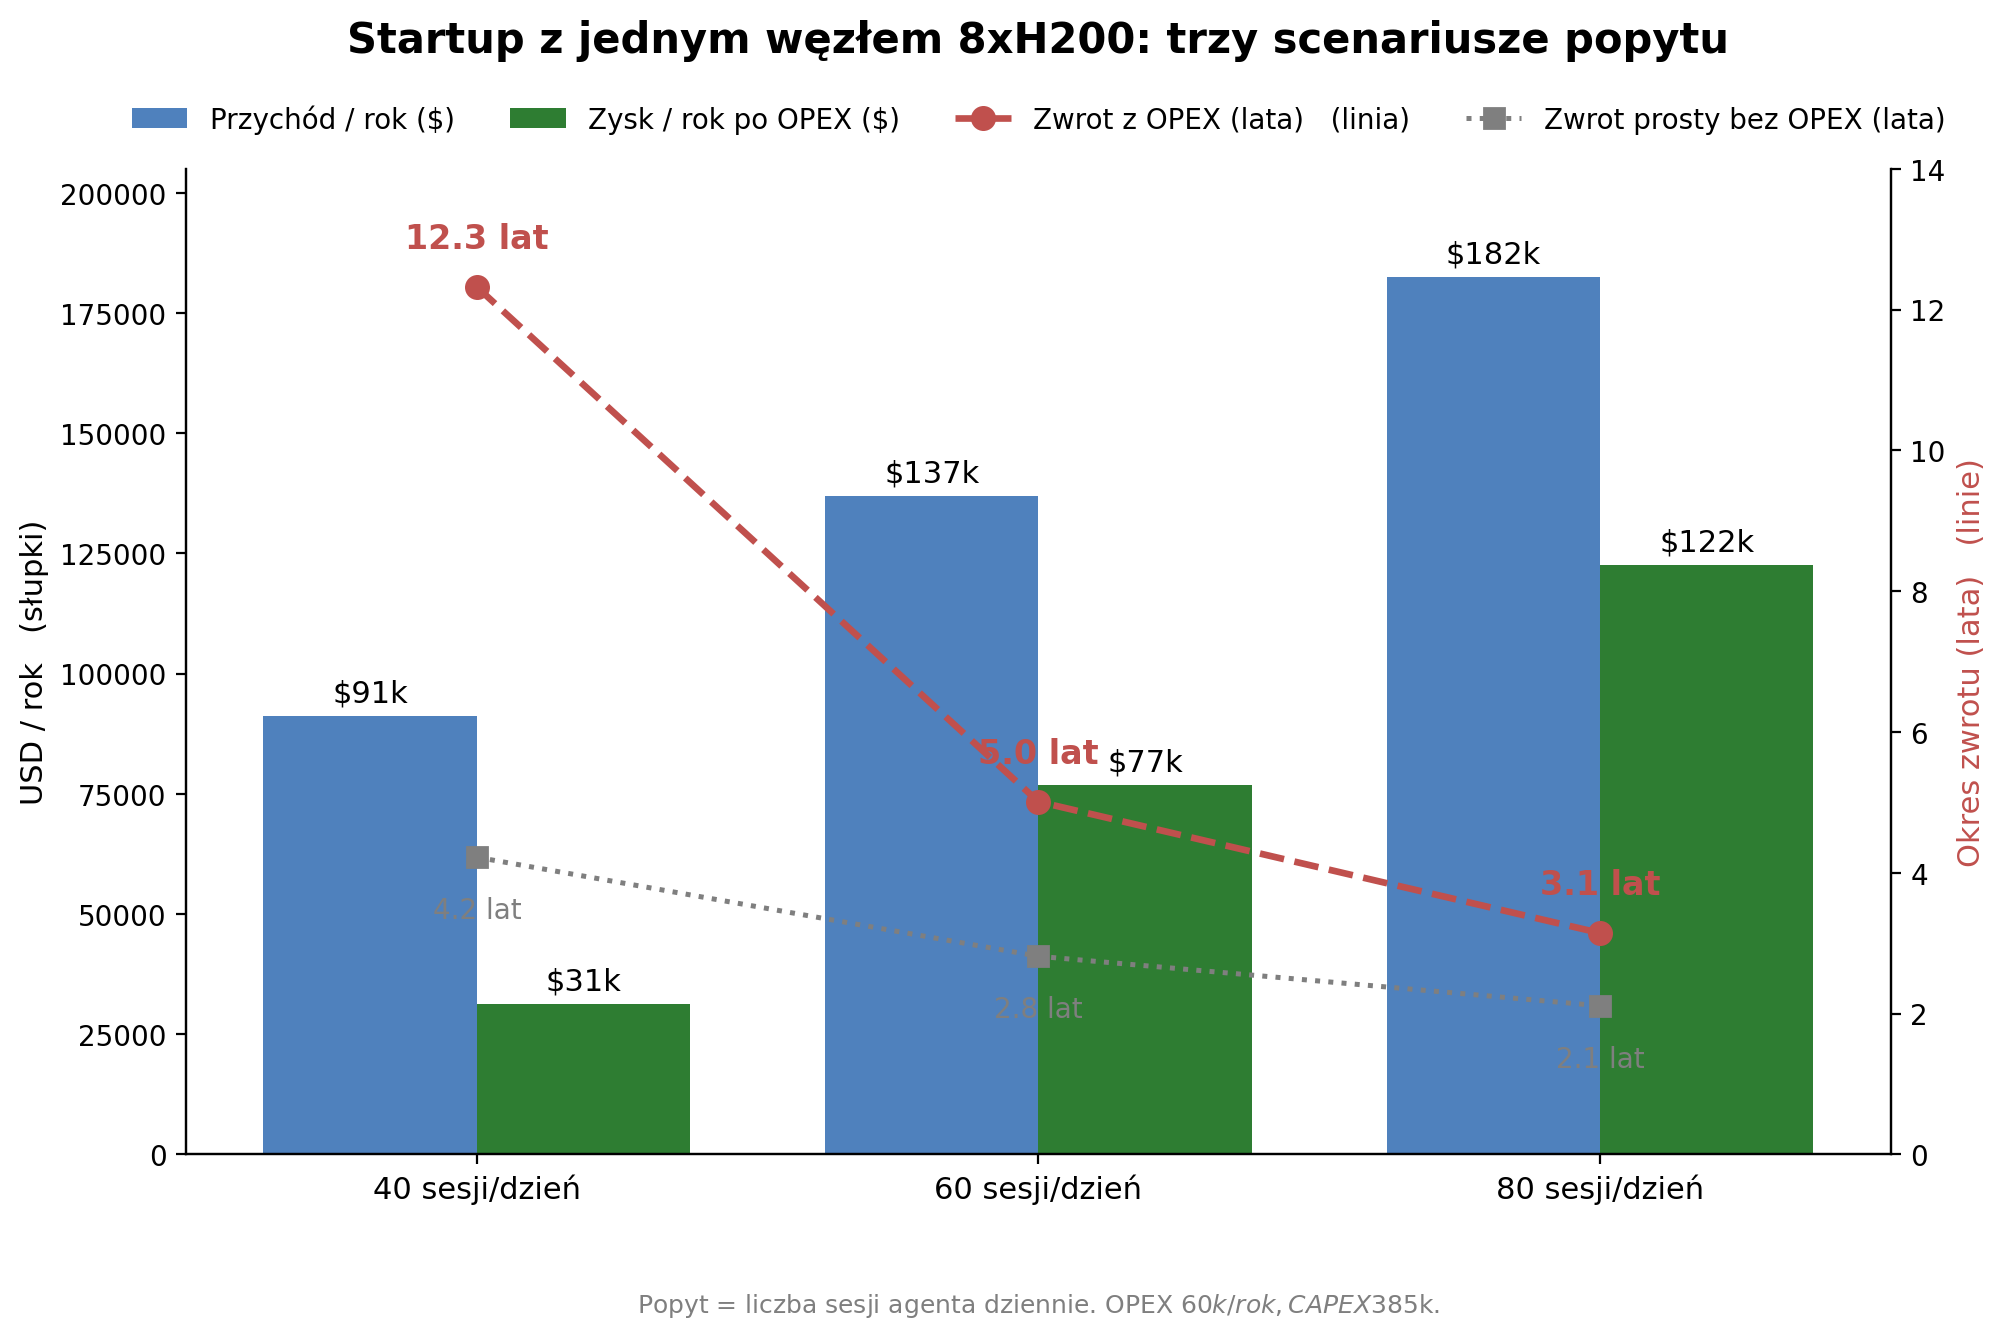
Wynik jest jednoznaczny. Przy 40 sesjach dziennie, co odpowiada ok. 20 mld tokenów, zwrot rozciąga się na ponad dwanaście lat. Dopiero przy 80 sesjach dziennie, czyli blisko pełnym obłożeniu, schodzimy do trzech lat. Krótko mówiąc: własny produkt po cenie bliskiej kosztu nie zwraca się, dopóki węzeł niemal nie pęka w szwach. To biznes o bardzo cienkiej marży i ogromnej wrażliwości na popyt.
A gdyby sprzedawać samą moc
Model A zmienia wszystko. Skoro węzeł produkuje tokeny po 0,011 USD, a rynek płaci ok. 0,15 USD, to wystarczy umiarkowane wykorzystanie, żeby biznes się spinał.
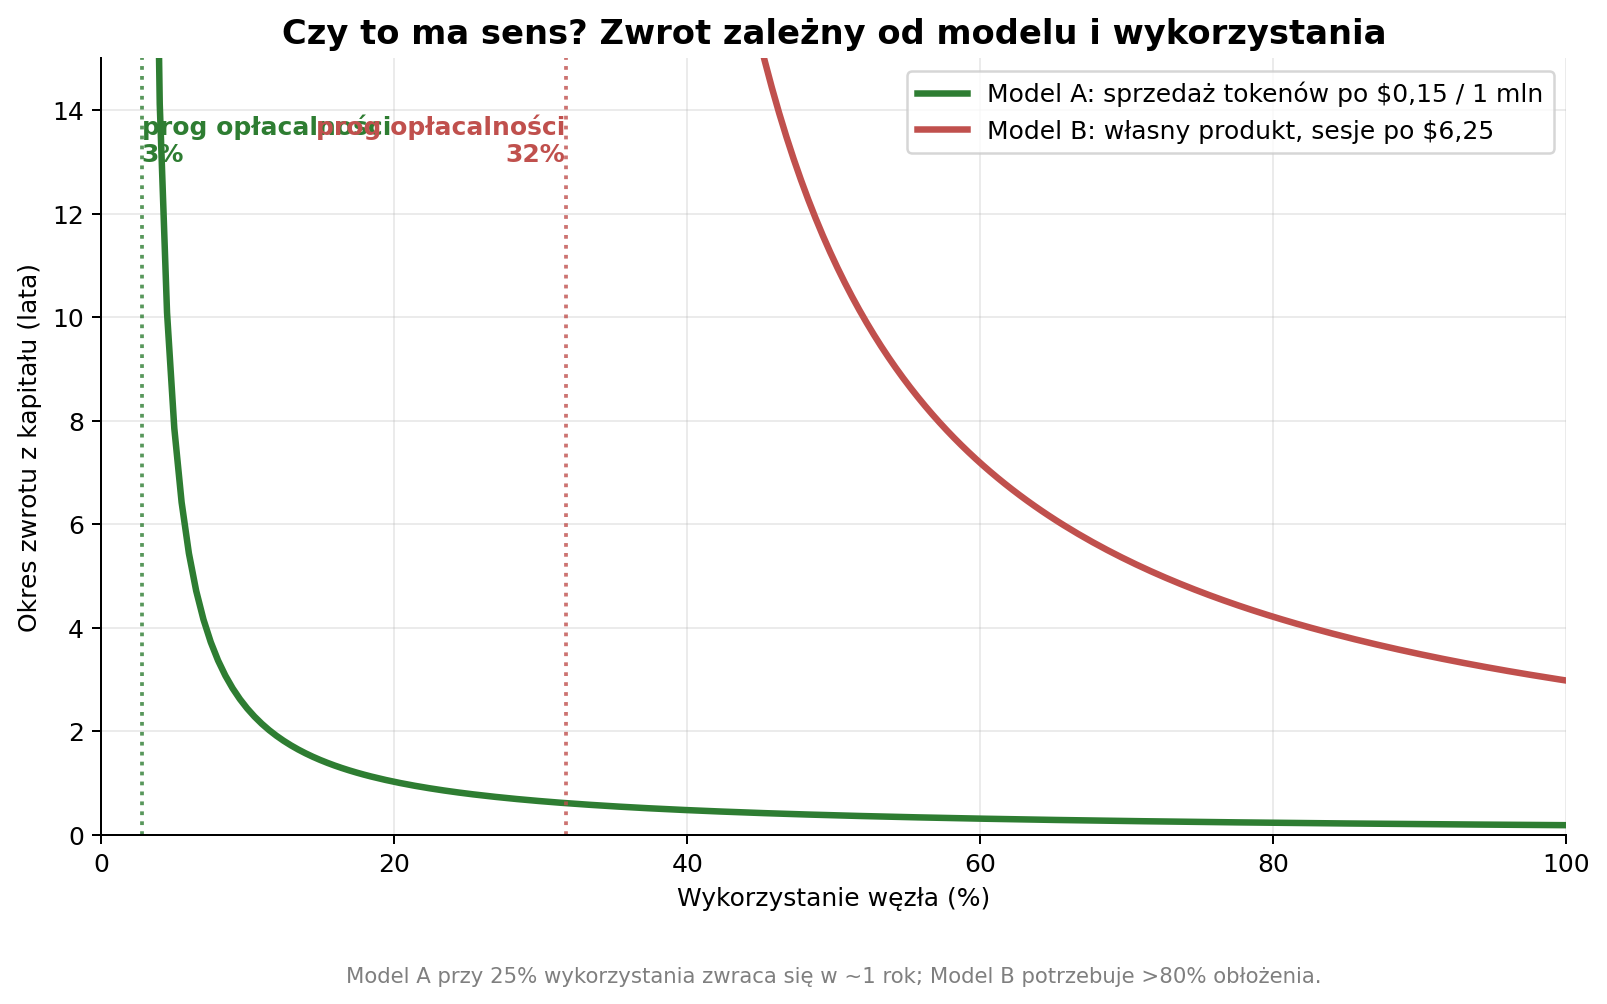
Progi opłacalności są skrajnie różne. W Modelu A wystarczy ok. 3% wykorzystania, by pokryć koszty operacyjne i zacząć spłacać kapitał. W Modelu B próg ten wynosi ok. 32%, a rozsądny zwrot pojawia się dopiero powyżej 80%.
Sama wrażliwość na cenę i wykorzystanie wygląda tak:
| Wykorzystanie | $0,05 / 1 mln | $0,10 / 1 mln | $0,15 / 1 mln | $0,30 / 1 mln |
|---|---|---|---|---|
| 10% | 29,6 roku | 4,5 roku | 2,4 roku | 1,0 roku |
| 25% | 3,1 roku | 1,3 roku | 0,8 roku | 4,4 miesiąca |
| 50% | 1,3 roku | 7,3 miesiąca | 4,4 miesiąca | 2,2 miesiąca |
| 80% | 8,7 miesiąca | 4,2 miesiąca | 2,8 miesiąca | 1,3 miesiąca |
Zastrzeżenie jest istotne: to liczby brutto, bez kosztów sprzedaży, marketingu i bez presji cenowej. Ceny tokenów z roku na rok spadają, a każda obniżka ceny rynkowej natychmiast pogarsza całą tabelę.
Czy taki startup ma sens
Odpowiedź brzmi: tak, ale tylko w jednym z dwóch ujęć.
Jako dostawca mocy obliczeniowej (Model A) pojedynczy węzeł ma sens. Kapitał jest niewielki jak na infrastrukturę, próg opłacalności leży bardzo nisko, a przy 25% wykorzystania zwrot następuje w nieco ponad rok. To rozsądny, choć niskomarżowy biznes.
Jako nośnik własnego produktu agentowego (Model B) ten sam węzeł sensu nie ma. Przy marży tokenowej bliskiej zeru potrzeba niemal pełnego obłożenia, a i wtedy zwrot trwa lata. Tanie wygenerowanie tokenów to nie to samo, co opłacalny biznes.
Decydującą zmienną nie jest więc koszt, lecz popyt. Węzeł jest tani w utrzymaniu i łatwo go zapełnić technicznie. Trudność polega na tym, by ktoś chciał kupić to, co on produkuje, po cenie wyższej niż koszt. Pojedynczy klaster to zatem dobry, niskokosztowy sondaż rynku. Nie jest jednak fosą. Przewagę daje tylko tempo, w jakim nadąża się za spadającymi cenami i kolejnymi generacjami sprzętu.
Dla porównania: skala dużych graczy
Na koniec tło, które pokazuje, dlaczego mikroskopijny węzeł w ogóle ma przestrzeń. Cztery największe amerykańskie spółki chmurowe zapowiedziały na 2026 rok łączny capex na poziomie 720-745 mld USD, niemal w całości na infrastrukturę AI.
| Spółka | Zapowiedziany capex 2026 |
|---|---|
| Amazon | ok. 220 mld USD |
| Alphabet | 195-205 mld USD |
| Microsoft | ok. 175 mld USD |
| Meta | 130-145 mld USD |
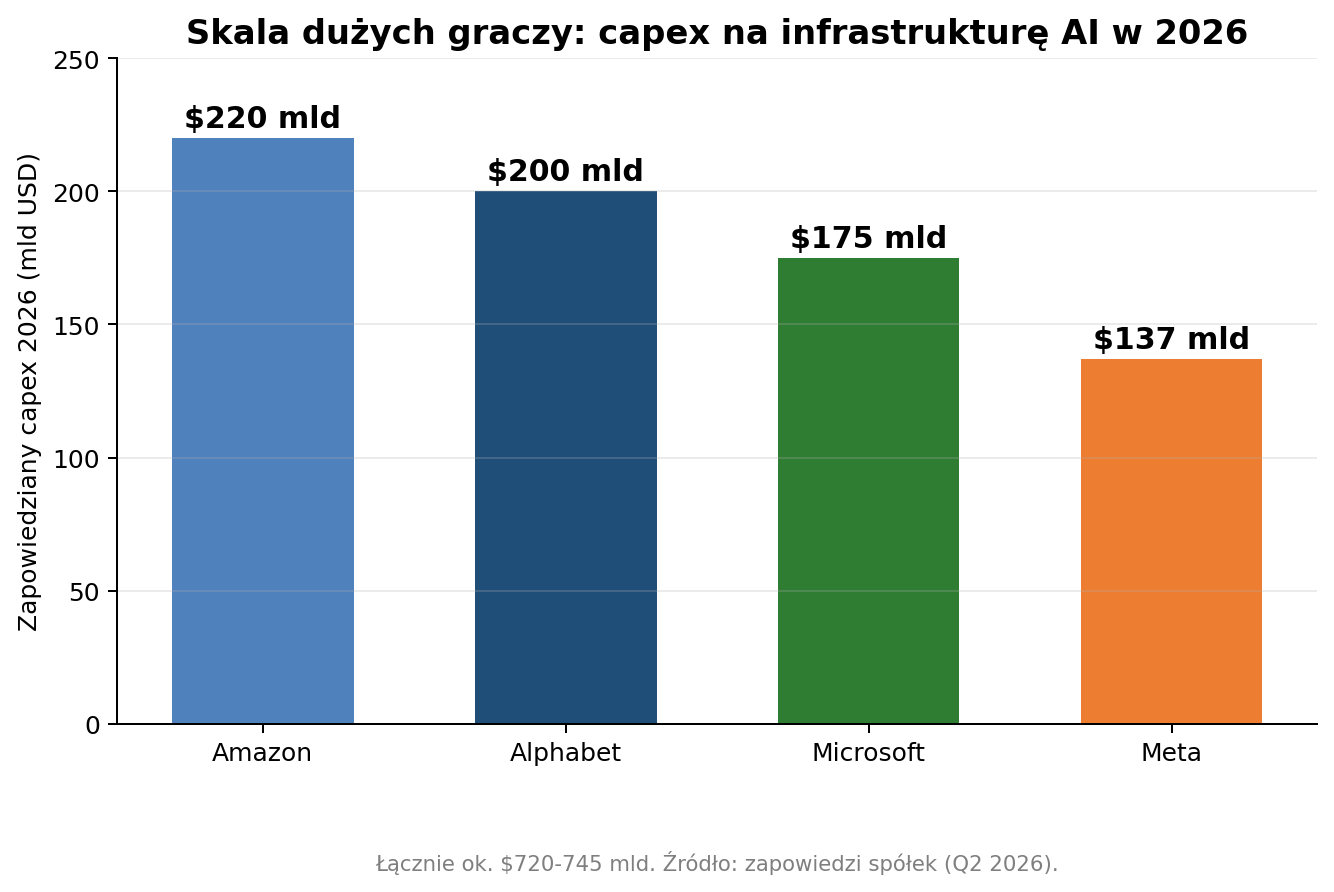
Dla skali: sam budżet Amazona odpowiada zakupowi ponad pół miliona węzłów takich jak nasz. Zużycie energii rośnie w podobnym tempie.
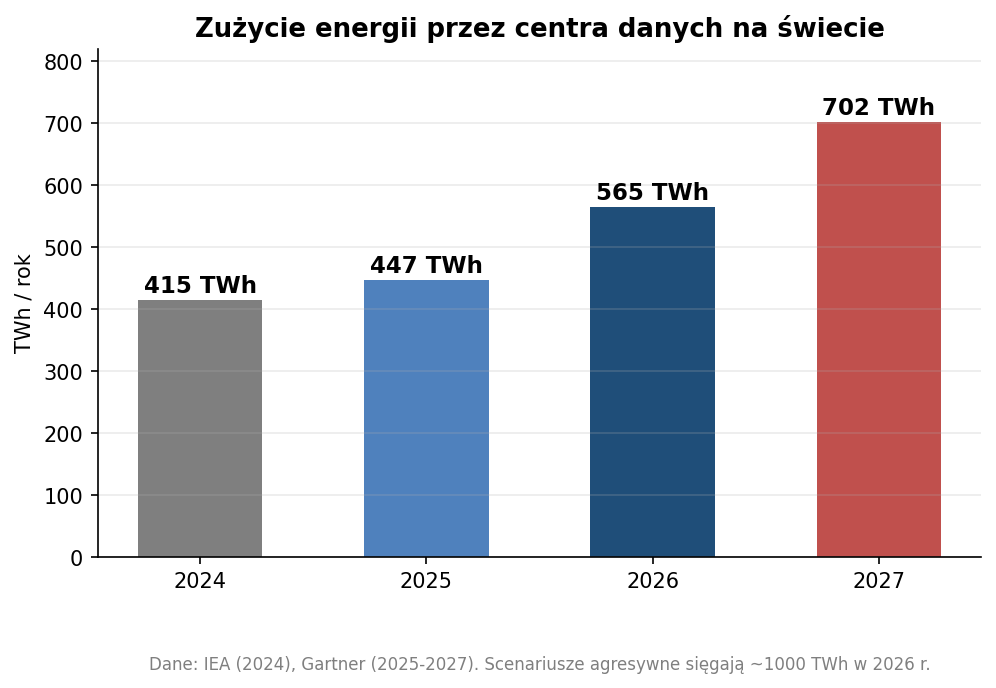
Z 415 TWh w 2024 roku do 702 TWh w 2027 roku, a scenariusze agresywne mówią o 1000 TWh już w 2026 roku, czyli o zużyciu porównywalnym z całym rocznym zapotrzebowaniem Japonii. To tłumaczy, dlaczego lokalizacja centrum danych coraz częściej zależy od dostępu do taniej energii. Dla małego gracza oznacza to jedno: kolokacja i prąd to warunek przetrwania, a nie detal.
Wnioski
Po pierwsze, ten sam model kosztuje w zależności od ścieżki od 0,011 USD lokalnie do 20 USD u dostawcy modelu SOTA. Ta rozpiętość to przestrzeń, w której może istnieć mały gracz.
Po drugie, rozliczenie za zużycie (API) jest uczciwe względem kosztu sprzętu i energii. Abonamenty ryczałtowe są silnie subsydiowane dla najcięższych użytkowników, a model agentowy to ekstremum tego zjawiska.
Po trzecie, dla startupu z jednym klastrem wszystko zależy od modelu biznesowego. Sprzedaż mocy zwraca się w miesiącach do dwóch lat. Własny produkt po cenie bliskiej kosztu potrzebuje lat i niemal pełnego obłożenia.
Po czwarte wreszcie, ryzyko nie leży w cenie tokenu ani w sprzęcie, lecz w wykorzystaniu i w tempie erozji cen. Węzeł za 385 tys. USD jest tani. Pytanie brzmi, czy ktoś zapłaci za to, co on wyprodukuje.
Źródła
- Machine Mind Ltd, One business day, one complete product (17 września 2026)
- IEA, Energy and AI
- Cennik DeepSeek V4.1-Flash (off-peak, szczyt, cache)
- DeepSeek V4.1-Flash na OpenRouter
- Porównanie cen API modeli (2026)
- Ceny modeli SOTA, wrzesień 2026
- Dane Gartnera o zużyciu energii przez centra danych
- Ceny i specyfikacje NVIDIA H200 (2026)
- Zapowiedzi capex hiperskalerów na 2026 rok
O autorze

Piotr Kurowski: badacz i inżynier sztucznej inteligencji, zajmuje się uczeniem maszynowym i sieciami neuronowymi. Prowadzi badania w OpenAI, wcześniej w polskim startupie AI i Google AI. Analityczny umysł, introwertyk typu INTJ. Objaśnia złożoność modeli AI w sposób zrozumiały dla każdego.